0x00 引言
上一篇博客介绍如何通过流量自动化分析入侵原因。而云上治理,快速的发现当前活跃的botnet也是重点,团伙的识别能帮我我们聚类到高风险目标。本文主要介绍如何通过采集的流量数据和进程数据快速的发现Botnet。
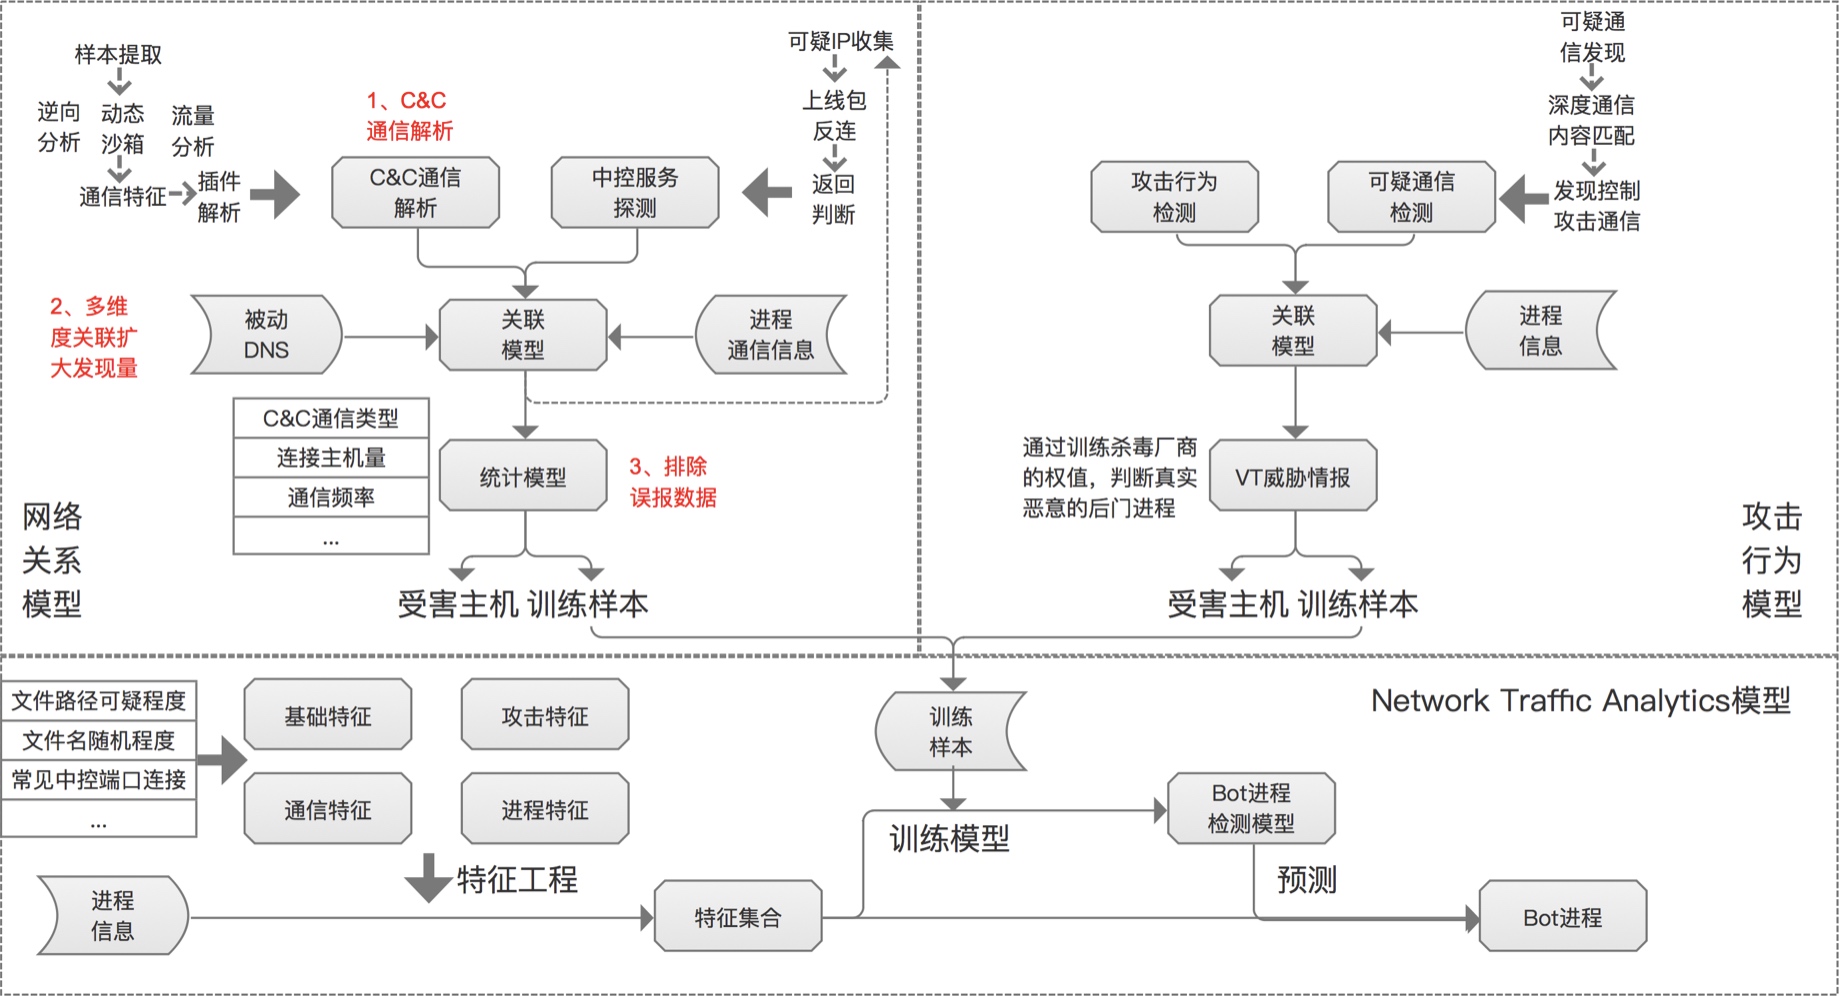
我们的武器库包含三大核心模型:网络关系模型(追踪C&C基础设施)、攻击行为模型(识别恶意进程行为特征)、NTA模型(机器学习驱动的异常检测) 。
0x01 网络关系模型:追踪C&C
1.1 核心思想
Botnet的无法隐藏的点是其C&C通信。无论僵尸网络如何进化——从早期的IRC Bot到HTTP-based Botnet,再到fast-flux和DGA等等——它们本质上都需要:与控制端保持通信。
网络关系模型的核心就是:通过识别和追踪这种通信关系,将整个僵尸网络的拓扑结构暴露出来。我们会通过已知的指纹提取,再利用图关联分析进行扩源。
1.2 C&C通信特征提取
识别Botnet的第一步是提取C&C通信特征。这需要从已知样本入手,通过多种技术手段获取协议特征。
特征提取方法矩阵
| 方法 | 描述 | 优势 | 局限性 |
|---|---|---|---|
| 逆向分析 | 反汇编恶意样本,提取硬编码的C&C协议 | 精确度高,可获取加密密钥甚至DGA算法 | 耗时耗人力 |
| 沙箱模拟 | 在隔离环境中运行样本,捕获网络通信 | 自动化程度高,可大规模部署 | 可能被反沙箱技术绕过 |
| 感染主机抓包 | 直接在已感染机器上抓取四层流量 | 真实数据,最为准确 | 包是乱序的,无法确认协议建联过程 |
以下是从不同Botnet家族提取的C&C通信特征检测规则:
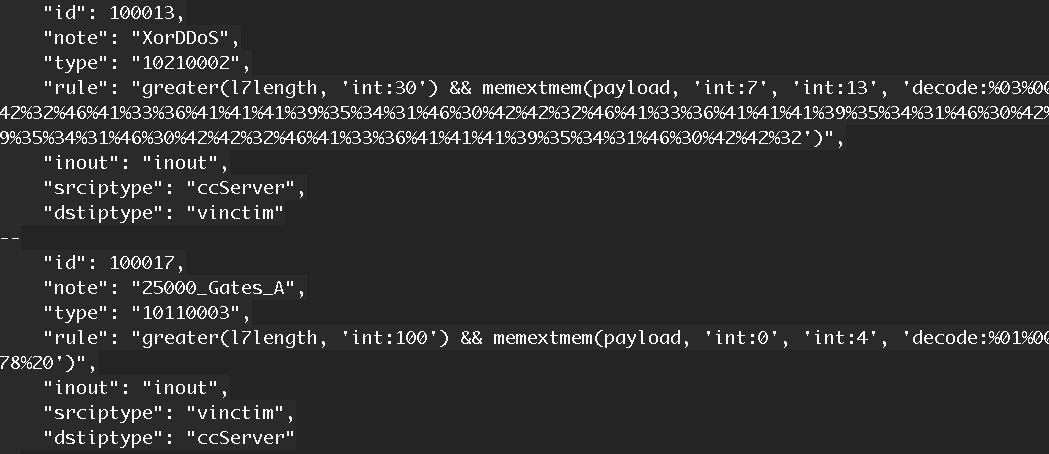
通过基于特征的检测规则,可以得到第一批中控(C&C)候选 + 感染主机(Bots)列表,但这只是开胃菜:我们需要通过扩源来发现更多的僵尸网络。
1.3 基于Passive DNS的Botnet追踪
获取初始的C&C特征后,我们需要进一步通过关联、预测等方式扩大追踪整个僵尸网络的基础设施。Passive DNS(通过监听历史的DNS解析记录,可以记录跟踪详细的历史DNS机器解析记录)是我们最有力的武器之一。
C&C 最常见的生存策略是:换域名、换 IP、fastflux等等。而 passive DNS 的价值在于:它记录了“所有域名历史曾经指向过哪里”,所以C&C的活动在详尽的passive dns记录下无所遁行。如通过抓到的中控IP,可以进一步关联出该IP历史解析的域名记录,通过该IP历史解析的域名记录也能进一步挖掘更多的中控IP,甚至发现用于服务发布的ns服务。
1.4 基于进程关联的Botnet追踪
云的优势在于我们拥有进程级别的可见性。通过分析感染主机上的进程网络行为,可以发现更多中控IP。因为如果一个进程曾经连接已知C&C IP被识别为受控进程,那么它连接的其他IP也值得怀疑。同时感染进程连接的目标也可能是连接的也可能是攻击IP,所以需要通过统计维度进行过滤。
1.5 误报消除(降噪与过滤)
扩源后的数据必然包含大量误报。我们通过两个思路来净化数据:
方案一:主动探测
收集Botnet的上线包,反向连接可疑C&C进行探测:模拟 Bot 发送合法的“上线包”至疑似中控,观测返回包是否符合该Bot的上线特征(返回码、字段结构、长度分布、加密握手步骤是否符合)。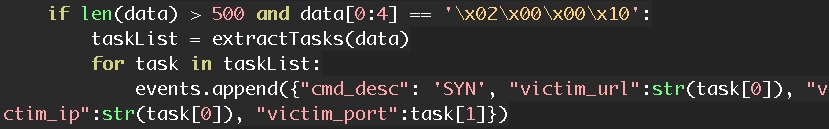
方案二: 统计过滤
- 命中特征种类数
- 同一IP同时命中多种特征(HTTP指纹 + TLS指纹 + 上线包结构)更可信
- 连接主机量与活跃持续性
- 一天内被多少不同主机连接?连续出现几天?是否与攻击窗口吻合?
- 目的端口稳定性
- 多host对同一端口的集中连接,比分散端口更像中控服务
- 地理分布
- 僵尸网络通常分布广泛,存在跨地域特征
0x02 攻击行为模型:收集未知C&C
2.1 设计思路
网络关系模型依赖C&C特征,但某些新型Botnet的特征尚未被收录,或者使用了高度定制化(如自定义加密通信,所有case都逆向分析成本太高)的协议。这时候,我们需要从攻击行为入手。
攻击行为模型的核心逻辑:即使C&C通信隐藏得再好,Bot最终要执行恶意行为,恶意行为是无法隐藏的,可以通过抓取恶意行为节点识别他们所共同连接的中枢就是C&C。
2.2 蠕虫扫描行为特征
扫描是蠕虫传播的核心手段。我们监控进程的网络行为,识别典型的扫描模式。DDoS攻击是蠕虫最常见的变现手段。
- 扫描行为:监控进程是否在短时间内发起大量的 TCP SYN 包,且连接成功率极低,目标分布极其离散,通常集中在一些高危端口(22/445/3389/2375)
- DDoS行为:基于已有的DDoS检测能力,不赘述。
2.3 二进制校验
目前只是基于进程的行为发现的可疑进程列表,还需要评审给出明确的判定依据。首先可以通过二进制hash进行聚类,确认可能的家族。然后结合VirusTotal的多引擎扫描对hash进行快速的识别,是否恶意进程。
0x03 NTA模型:机器学习放大
3.1 从规则到智能
前两个模型依赖人工规则和专家经验,但Botnet在不断进化。我们需要一种能够自适应学习的方法——这就是Network Traffic Analytics(NTA)模型的价值所在。通过特征工程收集足够多的特征,然后基于前面标准的样本训练二分类模型(实际使用中xgboost效果最好)。
3.2 特征工程:安全专家的经验量化
原始的进程网络连接数据维度单一,需要结合安全经验进行特征增强:
特征维度总览
3.3 特征详解
特征一:进程路径风险评分
后门常出现在特殊路径:Windows Temp目录、Linux /tmp目录、伪装系统路径等。这些人在分析时是以经验的方式沉淀的,而针对机器学习模型,必须有办法量化度量,我们可以通过比例统计来将其量化。最终路径风险的计算方式是:
路径风险分 = 该路径出现恶意进程的主机数 / 该路径出现任意进程的主机数
高风险路径示例:
| 路径模式 | 正常主机占比 | 异常主机占比 | 风险评分 |
|---|---|---|---|
/tmp/.* | 15% | 78% | 0.84 |
/var/tmp/.* | 8% | 72% | 0.90 |
/dev/shm/.* | 3% | 65% | 0.96 |
C:\Windows\Temp\.* | 22% | 71% | 0.76 |
C:\Users\*\AppData\Local\Temp\.* | 45% | 82% | 0.65 |
/usr/sbin/sshd | 99% | 12% | 0.11 |
特征二:文件名熵值
恶意软件经常使用随机生成的文件名来逃避检测。通过计算文件名的信息熵可以识别这种模式:
熵值计算:
H = -Σ p(x) × log₂(p(x))
其中 p(x) 是字符 x 在文件名中出现的概率。
熵值分布参考:
| 文件名类型 | 熵值范围 | 示例 |
|---|---|---|
| 正常可读 | 2.0 - 3.5 | nginx, sshd, python |
| 随机短串 | 3.5 - 4.2 | a3f7x, kj8m2 |
| 随机长串 | 4.2 - 4.8 | x8k3m9p2v5n7q |
| 高度随机 | >4.8 | f7a3k9m2x8p5v1n6q4w |
特征三:连接端口分布
进程连接的端口分布是重要的行为特征。
- 正常进程经常连接端口:80/443、53、3306、22…
- 风险进程经常连接端口:23/2323、445、2375、4444、矿池常见端口等
针对端口的连接次数是连续变量,且分布极不均匀,可以将其分桶离散化得到更好的训练效果。
特征四:父进程关系
恶意进程的父子进程往往具有特定模式:
- 孤儿进程
- 业务容器/脚本引擎拉起不该出现的二进制
- 同类异常进程共享同一父进程链
人工分析时能够有效的基于这些特征作为判断,所以我们可以将其作为标签辅助进行训练。例如:
| 父进程类型 | 说明 |
|---|---|
| Web服务进程(nginx/apache/php-fpm) | Webshell执行命令 |
| 数据库进程(mysql/postgres) | SQL注入后门 |
| 脚本解释器(python/perl/ruby) | 脚本执行 |
3.4 样本来源
- 正样本(恶意)
- 网络关系模型产出
- 攻击行为模型产出
- 负样本(正常)
- 长期稳定业务进程
- 系统组件
- 经过VT标注为正常的进程
0x04 三位一体:核打击Botnet : )
三个模型并非孤立运作,而是形成协同联动的检测体系: